Automação de Processos com Cenários de Automação
Este guia explica como estruturar um cenário de automação para padronizar rotinas, reduzir retrabalho e ganhar previsibilidade operacional. Em seguida, apresenta o contexto objetivo sobre automação de processos, a lógica por trás de cenários e os cuidados necessários para integrar regras, sistemas e governança de forma consistente.
1) Cenário de Automação: o que priorizar para resultados consistentes
Ao desenhar um cenário de automação, o ponto mais crítico não é “automatizar tudo”, mas sim escolher bem o que será automatizado e como as etapas se conectam. Um cenário bem estruturado transforma processos em fluxos controláveis: entradas claras, regras de decisão explícitas, tratamento de exceções e critérios de conclusão. Na prática, isso reduz variações entre equipes, melhora o rastreio de decisões e facilita auditorias internas.
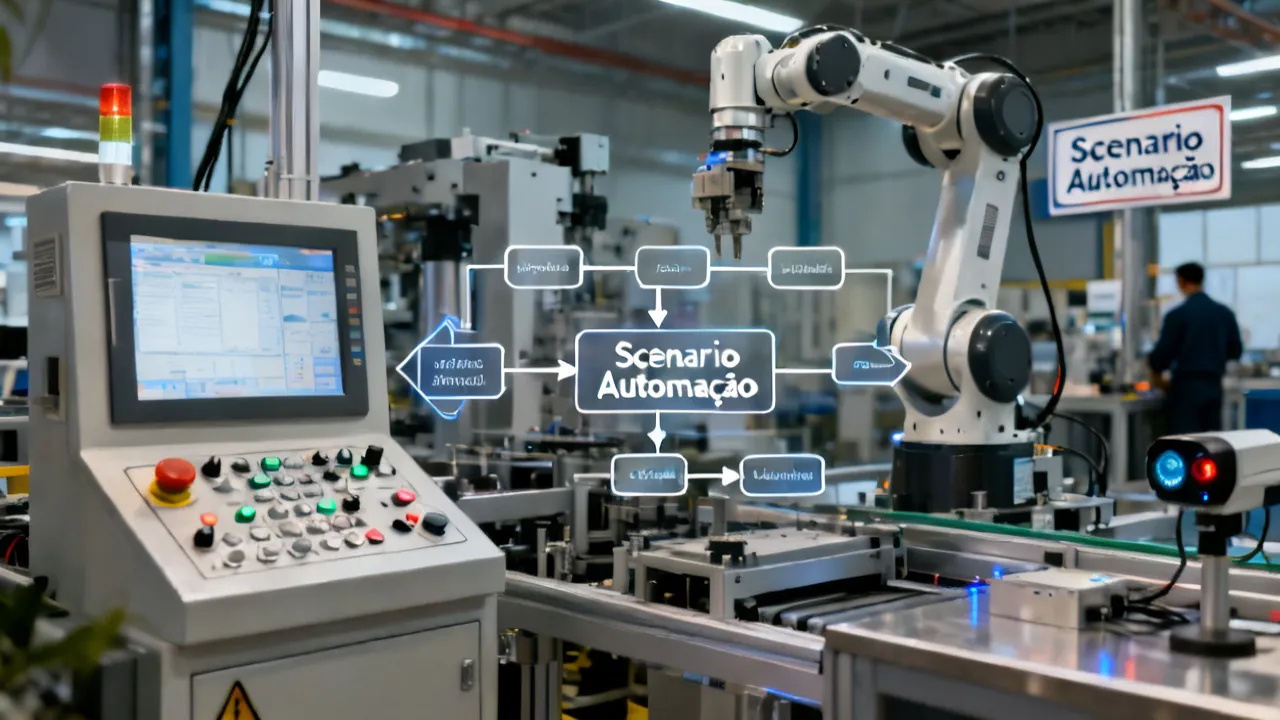
Para empresas que buscam Scenario Automação como abordagem de trabalho (e não apenas como ferramenta), recomenda-se começar por processos com: (i) alto volume, (ii) regras relativamente estáveis, (iii) baixo risco reputacional e (iv) dados disponíveis para validação. Esse alinhamento entre automação e governança evita “pilotos” desconectados do negócio.
Além disso, um cenário eficaz precisa considerar a realidade do ambiente: integrações legadas, idiossincrasias do time, restrições de compliance e a manutenção contínua. Especialistas em transformação digital normalmente tratam automação como produto vivo — com versionamento de regras, monitoramento e ciclo de melhoria — para sustentar valor no médio prazo.
Uma boa forma de assegurar consistência é alinhar automação com princípios de engenharia: determinismo (o mesmo input deve levar ao mesmo output, salvo exceções previstas), idempotência (executar duas vezes não deve duplicar resultados), e tolerância a falhas (falhas devem ser detectadas, registradas e tratadas). Esses princípios reduzem o “comportamento inesperado” que costuma aparecer quando o cenário cresce ou quando ocorrem mudanças em sistemas externos.
Outro ponto que costuma ser subestimado é a claridade semântica dos dados. Não basta automatizar com “campos” preenchidos: é necessário garantir que os campos representem o mesmo significado em todos os sistemas envolvidos. Exemplo: um campo “status” pode ter semântica diferente entre um ERP e um sistema de atendimento. Se o cenário assume a semântica de um lado e o outro sistema interpreta diferente, o fluxo pode se tornar logicamente correto “no papel”, mas incorreto na prática.
Também é essencial priorizar robustez operacional. Automação não é apenas executar. É operar continuamente. Por isso, o cenário deve contemplar: (a) rotinas de validação periódica de mapeamentos; (b) controle de mudanças (mudança de regra, mudança de mapeamento, mudança de integração); (c) políticas de rollback ou mitigação; e (d) definição de responsáveis (ownership) para o cenário. Sem isso, o cenário vira um ativo “sem dono”, sujeito a degradação ao longo do tempo.
Por fim, para ter resultados consistentes, é importante construir um modelo de governança do cenário no nível certo: não necessariamente uma burocracia pesada, mas um conjunto mínimo de ritos (revisão técnica e funcional, validação por testes, aprovação de mudanças e registro de evidências). Esse modelo cria previsibilidade e evita que cada alteração seja feita “na tentativa e erro”.
2) Onde a automação realmente agrega: previsibilidade e controle
Em termos operacionais, a automação tende a gerar maior retorno quando reduz:
- Retrabalho (ex.: reprocessos por falta de critérios ou inconsistência de dados);
- Tempo de ciclo (ex.: etapas manuais repetitivas);
- Erros de transcrição (ex.: cópia e colagem entre sistemas);
- Dependência de pessoas (quando tarefas viram rotinas rastreáveis).
Isso conversa diretamente com a ideia de Scenario Automação: em vez de automatizar “uma atividade isolada”, você cria um conjunto coerente de passos que pode ser testado e acompanhado como um todo.
Além dos ganhos diretos, existe uma camada menos tangível porém muito valiosa: previsibilidade. Quando o cenário está bem desenhado, a organização passa a saber com antecedência: quais etapas podem falhar, com que frequência, quais tipos de exceção são mais comuns e como recuperar. Essa previsibilidade melhora planejamento, reduz custo de incidentes e aumenta a confiança do time no sistema automatizado.
Controle também melhora porque o cenário define o que antes era “interpretativo”. Em processos manuais, decisões costumam ser baseadas em entendimento individual. No cenário, essas decisões se tornam regras codificadas (ou parcialmente codificadas) e ficam registradas: por que uma solicitação foi aprovada, por que foi reprovada, por que foi encaminhada, qual justificativa foi usada, qual evidência foi coletada. Quando auditorias chegam, essa rastreabilidade reduz drasticamente o esforço de reconstruir fatos.
Um bom cenário também define “o que significa sucesso” em linguagem de negócio. Por exemplo: “solicitação validada e registrada em até X horas” ou “exceções tratadas com registro e encaminhamento”. Sem esse critério, o monitoramento vira métrica sem intenção.
Para deixar o “sucesso” operacional, é comum decompor o objetivo em KPIs encadeados. Em vez de apenas “validar em X horas”, medir também: (1) tempo até o trigger; (2) tempo de validação; (3) tempo de execução das ações; (4) tempo de resposta em caso de exceção; (5) porcentagem de casos que seguem o caminho ideal. Esse encadeamento ajuda a localizar gargalos e evita otimizar uma etapa escondendo problemas em outra.
Também vale incluir indicadores de qualidade de resultado. Em muitos cenários, o problema não é a execução “falhar”, mas a execução “funcionar” com saída incompleta. Exemplo: uma automação cria um registro, mas deixa campos opcionais vazios; a taxa de sucesso operacional fica alta, mas a qualidade piora. Por isso, o cenário deve ter validações de completude e consistência do output.
Outra dimensão relevante é a aderência ao processo. Se o cenário substitui manualidades, ele deve refletir o fluxo de negócio esperado. Porém, também é possível usar automação como oportunidade de melhorar o fluxo. Uma abordagem madura não “congela” o processo; ela observa variações frequentes, identifica onde as exceções surgem e propõe ajustes para diminuir a taxa de exceções no médio prazo.
Por fim, automação com previsibilidade e controle exige que o cenário seja projetado para manter-se estável com mudanças inevitáveis. Isso envolve estratégias como: (a) tolerar atrasos e reordenação de eventos; (b) criar filas e estados para sincronização; (c) lidar com dados faltantes com políticas explícitas; e (d) garantir compatibilidade durante transições de versões em sistemas externos.
3) Componentes fundamentais de um Scenario de automação
Do ponto de vista de arquitetura e operação, um cenário costuma envolver cinco camadas:
- Triggers: o evento que inicia o fluxo (ex.: submissão de formulário, atualização em ERP, chegada de arquivo);
- Regras: condições e validações (ex.: elegibilidade, faixas, regras de negócio);
- Ações: o que acontece após a regra (ex.: registrar, notificar, movimentar dados, disparar aprovações);
- Exceções: como o processo reage quando algo foge do padrão (ex.: ausência de dados, conflito de registros, falha de integração);
- Observabilidade: logging, métricas e trilhas de auditoria para rastrear decisões.
Quando esses elementos são tratados com disciplina, a automação deixa de ser “magia” e passa a ser um mecanismo previsível. Isso é especialmente importante em ambientes que exigem rastreabilidade e controles formais.
Agora vale detalhar o que cada componente precisa conter para funcionar bem em cenários reais, onde o mundo não é perfeitamente determinístico.
Trigers (gatilhos) nem sempre são “simples eventos”. Em sistemas distribuídos, um gatilho pode chegar duplicado, atrasado ou fora de ordem. Por isso, um bom design de trigger normalmente inclui:
- Chaves de correlação (ex.: ID da solicitação, número do pedido);
- Política de deduplicação (evitar duplicidade);
- Estado (por exemplo, se o cenário já processou aquele ID);
- Janela de atraso (se eventos atrasados devem ser ignorados ou reprocessados);
- Idempotência na fase de execução.
Regras devem ser explícitas e, idealmente, separadas por domínio. Essa separação facilita a manutenção. Imagine que o cenário tem regras de elegibilidade e regras de classificação. Se tudo estiver misturado em uma única lógica grande, uma mudança em classificação pode causar efeitos inesperados em elegibilidade. Ao modularizar regras, a equipe consegue testar e versionar mais facilmente.
Além disso, regras precisam lidar com:
- Faixas e limites (ex.: valores mínimos e máximos);
- Ambiguidade (ex.: quando um campo pode representar mais de uma intenção);
- Codificações (valores “permitidos” e suas correspondências);
- Tratamento de nulos (o que significa ausência de dado? reprovado? pendente? solicitar complemento?);
- Condições compostas (ex.: se A e B então C, senão se D então E).
Ações vão além de “registrar”. Elas precisam considerar consistência transacional ou consistência eventual. Por exemplo, se uma ação cria registro em um sistema e atualiza status em outro, pode ocorrer falha no meio. O cenário precisa definir como proceder:
- Qual ação é “principal” e qual é “secundária”;
- Se há compensação (rollback lógico) em caso de falha;
- Se existem retries com limites;
- Se a consistência deve ser garantida por mecanismos do próprio sistema (ex.: transação) ou por design no cenário (ex.: orquestração com estados).
Exceções devem ser classificadas. Uma abordagem comum é criar categorias como:
- Exceção de validação (dados inválidos);
- Exceção de elegibilidade (regra de negócio não aprova);
- Exceção de integração (timeouts, indisponibilidade, falha de API);
- Exceção de concorrência (evento duplicado, atualização simultânea);
- Exceção de ordem (evento chegou fora de sequência esperada);
- Exceção de auditoria/segurança (falha de permissão, acesso negado).
Para cada categoria, o cenário precisa ter uma política: registrar motivo, criar ticket, encaminhar para revisão humana, reprocessar com atraso ou encerrar com reprovação fundamentada.
Observabilidade é o “sistema nervoso” do cenário. O ideal é que cada execução tenha um identificador de correlação (correlation ID) e que logs sejam estruturados (por exemplo, em JSON) com campos essenciais: trigger ID, tipo de evento, versão das regras, resultados de validação, códigos de erro e tempo por etapa.
Além dos logs, métricas ajudam a enxergar tendência. Métricas típicas incluem:
- Taxa de sucesso;
- Taxa de exceções por categoria;
- Tempo médio e percentis de execução;
- Tempo de recuperação em falhas de integração;
- Volume de execuções por dia/hora (para capacidade e escalabilidade).
Por fim, é importante que observabilidade esteja alinhada ao critério de sucesso. Se o objetivo de negócio é “resolver exceções em até X horas”, então existe uma métrica que mede isso, e existe alerta quando ultrapassa o limite.
4) Integrações, dados e governança: o trio que define o limite do cenário
Mesmo com boas regras, um cenário de automação pode falhar se a base de dados não estiver alinhada. Por isso, especialistas recomendam avaliar antecipadamente:
- Qualidade e completude dos dados de entrada;
- Normalização (padrões de campos, codificações e validações);
- Semântica (o que cada campo significa de fato no negócio);
- Controle de versão das regras;
- Segurança (acesso por função, segregação de tarefas e princípio do menor privilégio).
Em termos de governança, vale adotar uma rotina de manutenção: periodicidade para revisar regras, medir desempenho e ajustar exceções. Em organizações com maturidade, o ciclo inclui análise de incidentes, revisão de logs e atualização de documentação operacional.
O “limite do cenário” muitas vezes é determinado por integração e dados, não por lógica de regras. Isso acontece porque integrações têm variação e dados têm imperfeições. Uma API pode retornar atrasos, pode mudar contratos em atualizações e pode ter diferenças de precisão numérica ou formatos de datas. Por sua vez, dados podem conter strings com variações de acentuação, números com separadores diferentes ou campos obrigatórios que às vezes ficam em branco.
Para mitigar esse risco, recomenda-se criar uma camada de validação e transformação de dados antes de aplicar regras. Em outras palavras, o cenário pode ter etapas iniciais de normalização: converter formatos de data, padronizar códigos, validar esquemas e transformar unidades. Isso reduz as chances de regras “não se aplicarem” por detalhes de formato.
Governança, por sua vez, não é apenas “ter documentação”. É ter processos de decisão sobre mudança. Por exemplo:
- Quem pode alterar regras de elegibilidade?
- Quais regras exigem aprovação de compliance?
- Quais mudanças podem ser feitas em produção sem janela (hotfix) e quais precisam de release planejado?
- Como testar regressões quando uma regra muda?
- Como reprocessar dados que falharam após correção?
Essa governança deve refletir a criticidade do processo. Um cenário de baixa criticidade pode aceitar melhorias contínuas com ciclos curtos; um cenário regulado pode exigir validação mais formal, evidências e trilhas de auditoria mais robustas.
Um outro aspecto do trio é o alinhamento entre versionamento de dados e versionamento de regras. Se o formato de entrada muda (por exemplo, novo campo obrigatório) e as regras não são atualizadas, o cenário pode começar a falhar em massa. Ao mesmo tempo, se as regras mudam mas a transformação de dados não acompanha, pode haver regressão silenciosa. Por isso, a governança deve controlar também contratos de integração e esquemas de dados.
Também é importante garantir que o cenário seja seguro por design. Segurança em cenários de automação normalmente envolve:
- Autenticação e rotação de credenciais;
- Autorização via papéis (roles) e escopo mínimo;
- Criptografia em trânsito e em repouso, quando aplicável;
- Proteção de dados sensíveis (mascaramento em logs, cuidado com PII);
- Segregação de ambiente (dev/test/prod com permissões e dados apropriados).
Além disso, em cenários que lidam com dados pessoais, vale considerar privacidade: o que deve ser registrado em logs? Existe necessidade de retenção? O cenário pode anonimizar ou pseudonimizar campos para reduzir risco? Essas perguntas são essenciais em ambientes regulados.
Para fechar, integração, dados e governança definem o limite porque determinam: (i) o quanto o cenário consegue operar com consistência; (ii) o quanto a organização consegue detectar problemas; e (iii) o quanto a organização consegue manter o cenário sustentável após mudanças. Se esse trio estiver fraco, a automação vira “eventos ocasionais” e perde o valor de capacidade contínua.
5) Preço e fornecedores: como avaliar sem cair em critérios superficiais
Você mencionou “preço” e “fornecedor”, mas não foram fornecidos valores específicos nem o nome de um fornecedor. Ainda assim, é possível orientar o processo de decisão de forma objetiva, porque a análise de custo em automação raramente se resume ao valor da licença.
Na prática, o custo total costuma abranger:
- Licenciamento (por usuário, por capacidade, por volume de execuções ou por ambiente);
- Implementação (análise, modelagem, desenvolvimento, testes);
- Integrações (APIs, conectores, sincronização com sistemas legados);
- Infraestrutura (quando aplicável: ambientes, servidores, escalabilidade);
- Governança e manutenção (monitoramento, atualização de regras, gestão de mudanças);
- Treinamento e documentação operacional.
Ao selecionar fornecedores, priorize evidências: referencias de projetos com requisitos semelhantes, clareza sobre limites do produto, capacidade de integração e suporte para ciclos de melhoria. Como diretriz, avalie também SLA, rastreabilidade e aderência a requisitos de auditoria — elementos que geralmente impactam mais do que “tabela de preço” isolada.
Para avaliar com profundidade, uma prática útil é separar o custo em custo de aquisição (CAPEX/Setup) e custo de operação (OPEX/Run). Em automação, muitas vezes o setup é alto (integração, modelagem, testes), mas a operação pode ser relativamente previsível; em outros casos, o setup é baixo mas o custo de operação cresce com manutenção e gerenciamento manual de exceções.
Outro ponto: preço por execução pode parecer barato até você entender a taxa de retries, o custo de processamento em eventos duplicados e o custo de manter filas/estados. Em cenários com integração instável, a taxa de falhas pode elevar o custo de forma indireta. Por isso, vale pedir ao fornecedor:
- Como o produto trata retries e deduplicação;
- Se existem limites de performance por ambiente;
- Como funcionam limites de fila, escalabilidade e latência;
- Quais métricas e relatórios estão disponíveis (para observabilidade);
- Como é o modelo de suporte técnico e incident response.
Também é importante avaliar a capacidade do fornecedor em cenários de mudança. Muitas organizações enfrentam mudanças em sistemas legados, ajustes de APIs e novas regras regulatórias. Se a plataforma ou ferramenta não facilita versionamento, auditoria e testes de regras, você pode pagar “em manutenção” o custo que supostamente economizou na licença.
Se você tiver um fornecedor específico e valores (por exemplo, custo mensal por licença ou estimativa de implementação), posso ajudar a estruturar uma comparação de custo total (TCO) alinhada aos seus processos.
Para deixar essa avaliação aplicável, você pode montar uma matriz com colunas como: “capacidade técnica”, “custo”, “impacto na operação”, “risco”, “esforço de manutenção”, “aderência a compliance” e “tempo para colocar em produção”. Assim, a comparação fica menos emocional e mais baseada em evidências, evitando cair em critérios superficiais como “menor preço hoje” sem considerar o custo de risco e manutenção.
6) Abordagem recomendada: desenhar, validar e colocar sob controle
Uma estratégia de Scenario Automação robusta costuma seguir um fluxo de trabalho com foco em validação e controle. Em vez de começar com o “processo inteiro”, o padrão recomendado é:
- Definir um escopo inicial com critérios de aceite;
- Modelar o cenário com regras explícitas e tratamento de exceções;
- Realizar testes com dados reais e cenários de falha;
- Instrumentar logs e métricas para observabilidade;
- Executar piloto com acompanhamento e plano de correção;
- Expandir gradualmente, mantendo governança de mudanças.
Esse modo de agir evita o erro comum de automatizar um processo “como está”, perpetuando problemas estruturais. Em geral, automação bem feita exige melhoria do processo — nem que seja ajustes finos — para que as regras produzam resultados estáveis.
Uma forma útil de aprofundar essa abordagem é tratar cada etapa como uma “porta de qualidade”. Antes de passar para a próxima fase, você verifica se o cenário atende requisitos mínimos:
- Escopo inicial: existe definição clara do que entra e do que sai? Existem exemplos reais de input e output?
- Modelagem: as regras estão documentadas em linguagem funcional? As exceções têm política?
- Testes: os testes incluem casos de borda? Existem dados para validar completude?
- Observabilidade: logs e métricas existem? Há correlação entre execução e registro?
- Piloto: os critérios de sucesso foram monitorados? Há plano de resposta para incidentes?
- Expansão: existe plano de versionamento e governança? Existe processo de rollback/mitigação?
Também vale considerar uma estratégia de controle de versões mais detalhada do que “atualizar o fluxo”. Em um cenário maduro, as regras devem ser versionadas com histórico, para que seja possível responder: quando a mudança aconteceu, qual impacto ocorreu, e como reprocessar casos que foram executados com uma versão anterior.
O piloto deve ser mais do que “colocar para rodar”. Ele deve ter um desenho experimental: por exemplo, comparar o volume processado pelo cenário com o volume processado manualmente, ou comparar qualidade de output, ou ainda verificar divergências. Em empresas maiores, um piloto pode ser feito por “segmentos” (por região, por tipo de cliente, por faixa de produto), reduzindo risco enquanto se aprende sobre a variabilidade real.
Por fim, colocar sob controle significa garantir que a automação seja monitorada por alertas e procedimentos. Não basta observar; é preciso ter rotinas de ação quando algo dá errado: quem atende? qual prioridade? qual janela para reprocessar? como comunicar impacto ao time de negócio? Esse conjunto de procedimentos transforma o cenário em capacidade operacional confiável.
7) Tabela comparativa: cenários de automação, uso e requisitos
Como complemento, segue uma comparação prática entre abordagens comuns de automação por cenário. Não inclui links.
| Abordagem | Quando faz mais sentido | Principais requisitos | Riscos típicos |
|---|---|---|---|
| Automação orientada a regras | Processos com critérios estáveis e validações claras | Regras documentadas, boa qualidade de dados, definição de exceções | Regras desatualizadas; baixa cobertura de exceções |
| Automação orientada a eventos | Fluxos iniciados por mudanças (status, eventos em sistemas) | Trilhas de eventos confiáveis, idempotência, correlação de registros | Duplicidade de execuções; inconsistências em atrasos de integração |
| Automação com etapas aprovativas | Quando decisões exigem revisão humana em casos específicos | Fluxo de aprovação, critérios de encaminhamento, auditoria | Gargalo de aprovações; critérios pouco claros |
| Automação com reprocessamento controlado | Processos com falhas esperadas (integrações intermitentes) | Política de retry, filas/controle de estado, logs de diagnóstico | Reprocessar sem critério; loops de falha |
Vale observar que, na prática, muitos cenários combinam abordagens. Um fluxo pode ser orientado a eventos (trigger por mudança), usar automação orientada a regras (validação e elegibilidade), ter etapas aprovativas (em exceções específicas) e incluir reprocessamento controlado (para falhas de integração). Essa combinação costuma aumentar robustez — mas também aumenta complexidade; por isso, modularização e observabilidade são ainda mais importantes.
8) Guia passo a passo: como montar um Scenario Automação com robustez
A seguir, um roteiro prático e sequencial para construir um cenário de automação com foco em qualidade operacional.
Passo 1: Mapear o processo e definir a fronteira do cenário
Documente o fluxo atual (incluindo “variantes” e exceções). Em seguida, delimite o que entra no cenário e o que fica fora. Um cenário bem definido evita dependências ocultas e reduz retrabalho.
Mapear vai além de desenhar um fluxograma. O ideal é capturar informações como:
- Quais passos são executados sempre e quais variam;
- Quais sistemas participam e quais deles são fonte da verdade;
- Quais tipos de documentos/dados são usados e como são validados;
- Onde as exceções ocorrem com maior frequência;
- Quais decisões são tomadas manualmente e com base em quais critérios.
Também é útil identificar variantes de entrada (por exemplo, diferentes tipos de cliente ou produto) e variantes de condição (por exemplo, mudanças de status em diferentes momentos do ciclo). Esse mapeamento ajuda a desenhar regras que cubram a realidade.
Passo 2: Identificar entradas, saídas e critérios de sucesso
Defina:
- Entradas (campos e formatos);
- Saídas (registros criados/atualizados, notificações, atualizações de status);
- Critérios de sucesso (tempo, completude, conformidade);
- Critérios de reprovação/escala (quando precisa de correção manual).
Para robustez, inclua também critérios de qualidade e consistência. Em vez de apenas “criar registro”, defina “criar registro com campos A, B e C preenchidos de acordo com regras X”. Se possível, estabeleça testes de regressão de qualidade: por exemplo, amostras de execuções devem manter taxa de preenchimento acima de determinado limite.
Além disso, defina políticas de “estado final”. Por exemplo, uma execução pode terminar em:
- Concluído com sucesso;
- Concluído com reprovação (com motivo registrado);
- Encaminhado para revisão humana;
- Pendente (aguardando dados ou evento futuro);
- Falha técnica (integração indisponível ou erro não tratável).
Sem isso, o cenário pode registrar “sucesso” onde, na prática, o caso ainda não foi resolvido.
Passo 3: Modelar regras e decisões
Transforme o conhecimento do time em condições explícitas. Em cenários complexos, recomende-se separar regras por domínio (ex.: elegibilidade, validação, classificação) para facilitar manutenção.
Ao modelar regras, preste atenção ao tratamento de incerteza. Em processos reais, existem campos “aproximados” (por exemplo, CEP válido mas sem correspondência no cadastro) e existem dados que podem mudar durante o ciclo. Decida como o cenário lida com isso:
- Se o dado for “aproximado”, o caso deve ser aprovado ou encaminhado?
- Se um campo vier inconsistentes, o cenário deve corrigir automaticamente ou solicitar confirmação?
- Em conflitos, qual sistema prevalece?
Essa fase também deve prever “versionamento funcional”. Documente cada regra com nome, objetivo, versão e dependências. Assim, quando houver mudança, fica claro o que mudou e o que pode impactar.
Passo 4: Desenhar o tratamento de exceções
Preveja o que acontece quando:
- Dados estão ausentes ou inválidos;
- Integrações falham;
- Há conflito de registros;
- O evento chega fora de ordem;
- O sistema de destino não está disponível.
O objetivo é que o cenário registre causa, aplique política de correção e ofereça encaminhamento claro.
Uma prática recomendada é criar um catálogo de exceções com:
- Código da exceção (padronizado);
- Categoria (validação, integração, concorrência, segurança, etc.);
- Condição que dispara a exceção;
- Ação automática (retry, encaminhar, reprovar);
- Mensagem para time de operação (o que precisa ser feito);
- Tempo máximo antes de escalonar.
Isso reduz o caos operacional quando o volume aumenta. A equipe de suporte não precisa “inferir” o que aconteceu; ela recebe instruções baseadas em código e motivo registrados.
Também é importante projetar a política de retries. Reprocessar pode resolver falhas temporárias, mas reprocessar sem critério pode causar loops e custo adicional. Uma boa política inclui:
- Limite de tentativas;
- Backoff exponencial;
- Jitter (quando aplicável) para evitar tempestade;
- Critério para parar (por exemplo, erro 4xx de validação não deve ser reprocessado como integração);
- Registro de tentativa e diagnóstico para investigação.
Para conflitos e eventos fora de ordem, o cenário deve usar estados e checagens. Exemplos:
- Se o evento indica “status X”, mas o registro já está em status Y, o que ocorre? A execução deve ser ignorada, revertida ou atualizada conforme política?
- Se eventos chegam fora de ordem, existe janela de tolerância ou mecanismo para reordenar?
Passo 5: Instrumentar observabilidade (logs, métricas e auditoria)
Sem observabilidade, a automação vira “caixa-preta”. Defina logs por etapa, correlação entre execução e registros, e métricas mínimas como tempo de ciclo e taxa de exceções.
Além do “mínimo”, vale definir padrões de auditoria. Se a organização precisa demonstrar conformidade, é comum exigir:
- Trilha de decisão (quais regras foram avaliadas e quais condições foram verdadeiras/falsas);
- Versão das regras e versão do cenário;
- Evidências coletadas (por exemplo, fonte dos dados, payload original ou hash);
- Quem alterou a regra e quando (change management);
- Em caso de aprovação humana, o registro do aprovador e a justificativa.
Observabilidade também precisa integrar alertas. Defina alertas para:
- Queda de taxa de sucesso;
- Picos de exceção por categoria;
- Aumento do tempo de ciclo;
- Aumento de execuções pendentes;
- Falhas técnicas relevantes (por exemplo, erro de autenticação no conector).
O objetivo é detectar antes que o negócio sinta. Alertas cedo evitam que o sistema acumule pendências ou cause backlog.
Passo 6: Validar com testes realistas
Use dados representativos e inclua casos de borda. O teste deve cobrir tanto o caminho “ideal” quanto as variações reais do negócio.
Uma validação madura inclui pelo menos três tipos de testes:
- Teste funcional: as regras e ações fazem o que deveriam;
- Teste de exceção: falhas e dados ruins são tratados conforme política;
- Teste de integração: como o cenário se comporta quando sistemas externos demoram ou falham.
Também é comum executar testes de carga e escalabilidade quando o processo é de alto volume. O objetivo não é apenas “rodar mais rápido”, mas confirmar que filas, estados e deduplicação continuam corretos sob carga.
Além disso, inclua testes de regressão sempre que uma regra mudar. Se a equipe muda a regra de elegibilidade, mas a semântica do output muda, o impacto pode aparecer em etapas posteriores. Sem regressão, a automação pode causar inconsistência silenciosa.
Passo 7: Piloto com acompanhamento e plano de correção
Durante o piloto, monitore indicadores definidos no critério de sucesso e registre falhas com prioridade. Ajuste regras e exceções antes de ampliar volume.
O acompanhamento do piloto deve ser orientado por fatos. Por exemplo:
- Quais exceções aparecem mais? Elas têm causa raiz identificada?
- Existe divergência entre automação e execução manual?
- Quais dados de entrada estão falhando mais: mapeamentos, formatação, cadastros?
- O tempo de ciclo atende as metas?
- O cenário respeita SLAs de recuperação em falhas de integração?
O plano de correção deve definir rotas: quando ajustar regras, quando corrigir integração, quando melhorar dados de entrada, quando alterar processo. Piloto sem plano de correção tende a “apagar incêndios” em vez de melhorar sistematicamente.
Passo 8: Colocar em operação e manter governança
Crie um procedimento de mudança: quando uma regra muda, documente motivo, impacto, testes realizados e validação pós-mudança. Assim, o cenário permanece confiável ao longo do tempo.
Colocar em operação inclui também:
- Documentação operacional: como operar, como investigar falhas e como reprocessar casos;
- RACI (responsável, aprovador, consultado, informado) para incidentes e mudanças;
- Procedimento de incident response: classificação de severidade e tempo de resposta esperado;
- Treinamento do time de operação para entender exceções e instruções do catálogo;
- Revisão periódica: auditoria de logs e métricas para garantir que o cenário continua alinhado ao negócio.
Uma governança bem desenhada reduz a probabilidade de “degradação silenciosa”. Sem revisão, é comum acontecer: a taxa de exceções aumenta com o tempo (por mudanças em cadastros ou integração), mas ninguém percebe porque o painel não tem alertas ou porque ninguém revisa indicadores.
9) Condições e requisitos para um Scenario Automação funcionar bem
Para evitar frustração no rollout, considere estas condições:
- Regras estáveis ou com ciclo claro de revisão;
- Dados de entrada confiáveis e mapeamento consistente;
- Integrações com comportamento previsível (ou política de contingência);
- Observabilidade antes de escalar volume;
- Segurança e acessos alinhados ao princípio do menor privilégio;
- Responsável pelo cenário (ownership) e ritos de manutenção;
- Documentação para operação e auditoria.
Quando essas condições são atendidas, o Scenario Automação deixa de depender de “conhecimento informal” e passa a operar com padronização.
Vale expandir “dados confiáveis” e “comportamento previsível” porque são condições amplas. Dados confiáveis significa:
- O input respeita esquema (tipos, formatos);
- Existem validações para valores fora de faixa;
- Campos obrigatórios são de fato preenchidos na origem;
- Há clareza sobre correções: quem corrige? onde corrige? e como isso entra no cenário?
Já integração previsível significa:
- API tem contrato consistente e versionado;
- Há tolerância a latência e falhas;
- Existe política de retry adequada;
- Mensagens e eventos têm identidade para deduplicação;
- Existe documentação e capacidade do fornecedor ou time interno para investigar incidentes.
Observabilidade antes de escalar volume é uma condição “de engenharia”. Mesmo que o cenário funcione em pequena escala, sob carga a latência e as taxas de falha podem mudar. Sem observabilidade, vocês descobrem o problema tarde demais.
Outra condição essencial é o ownership. Sem ownership, o cenário fica “solto”: ninguém fica responsável por acompanhar métricas e fazer melhorias. Em um cenário que opera continuamente, ownership normalmente é compartilhado entre uma área de negócio (dono funcional) e uma área técnica (dono operacional). O importante é que exista clareza sobre o que cada um faz.
Finalmente, documentação é requisito porque automação “vive”. Quando o cenário muda, você precisa de contexto: quais decisões foram tomadas, qual lógica foi usada e por que certas exceções existem. Sem documentação, o custo de manutenção cresce e o cenário se torna um ativo difícil de evoluir.
10) FAQs sobre Scenario Automação e cenários de automação
1. O que significa “cenario de automação” na prática?
É o conjunto estruturado de etapas automatizadas, incluindo triggers, regras, ações, tratamento de exceções e observabilidade. Em vez de automatizar uma única tarefa, o cenário integra o fluxo completo para produzir resultados rastreáveis e consistentes.
2. Em quais processos a automação costuma ter melhor aderência?
Geralmente em rotinas de alto volume, com regras claras e pouca ambiguidade, onde o processo já tenha caminhos bem definidos e existam dados para validação. Quanto mais previsível o comportamento do processo, mais fácil é construir exceções e medir desempenho.
3. Como lidar com exceções sem tornar o cenário “complexo demais”?
Uma prática recomendada é classificar exceções por categoria (ex.: dado ausente, conflito, integração indisponível) e definir políticas de resposta. Também ajuda separar regras por domínio e manter um catálogo de exceções com critérios objetivos de encaminhamento.
Além disso, é recomendável tratar complexidade com modularização e limites. Por exemplo, em vez de criar exceções “ad hoc” para cada caso, crie categorias e map. Se uma exceção “nova” aparece com frequência, então vale refinar a categoria ou adicionar subcategorias. Dessa forma, a complexidade cresce de forma controlada.
4. Automação substitui totalmente o trabalho humano?
Na maior parte dos casos, não. Um modelo maduro combina automação e revisão humana em etapas específicas, especialmente quando há decisões subjetivas, impacto relevante ou necessidade de validação. O objetivo é reduzir trabalho repetitivo e tornar a operação mais controlável.
Em geral, o melhor arranjo é automatizar o caminho padrão e usar humano para exceções. Mas há exceções em que a automação pode ajudar mesmo sem substituir totalmente: por exemplo, automatizar coleta de dados, sugerir decisão e registrar justificativa, deixando a aprovação para o humano.
5. Como estimar custo sem dados do fornecedor?
Sem preço específico, você pode estimar por TCO: licenciamento, implementação, integrações, infraestrutura (se houver), manutenção e governança. A recomendação é criar uma matriz de requisitos e conversar com fornecedores para obter estimativas por volume e por cenário, incluindo esforço de integração e suporte.
Uma estratégia útil é estimar também custos de “incerteza”. Quanto do custo pode variar por dependências externas (APIs instáveis, qualidade de dados ruim, necessidade de retrabalho)? Muitas empresas subestimam esse componente. Inserir uma margem de risco e planos de mitigação melhora a precisão.
6. Quais métricas devo acompanhar após implementar o cenário?
Boas métricas incluem tempo de ciclo, taxa de execução bem-sucedida, taxa de exceções por categoria, tempo de recuperação em falhas e consistência dos dados de saída. Métricas devem estar ligadas aos critérios de sucesso definidos no início.
Se o cenário envolve aprovações humanas, monitore também SLA de aprovação e taxa de encaminhamento. Se envolve reprocessamento, monitore número médio de tentativas e taxa de falha após retries. Se envolve integração, monitore latência e taxa de timeouts.
7. Que tipo de documentação é necessário?
Para operação e auditoria, registre: definição do processo e do escopo, regras e exceções, mapeamento de campos, políticas de retries, procedimentos de atualização e evidências de testes. Essa documentação reduz risco e facilita manutenção.
Além disso, mantenha documentação “para investigação”. Em caso de incidente, o time precisa entender rapidamente: onde olhar, o que checar primeiro, quais logs são mais importantes e qual política de reprocessamento aplicar.
11) Referências e base conceitual (fontes para contextualização)
Este guia adota princípios amplamente recomendados para automação e governança em iniciativas digitais, sem depender de números não verificados. Para aprofundamento em práticas de gestão e alinhamento entre processos e tecnologia, são relevantes:
- Gartner (pesquisas sobre automação, hiperautomação e governança de processos; recomendações variam por contexto e maturidade).
- McKinsey (relatórios sobre automação e transformação digital, incluindo a necessidade de mudar processo e capacidades).
- NIST (publicações sobre segurança e princípios de controle; úteis para pensar observabilidade, gestão de risco e boas práticas).
Se você quiser, posso adaptar esta seção com fontes mais específicas conforme o seu setor (por exemplo: financeiro, logística, saúde ou indústria).
Mesmo sem citar fontes adicionais, vale lembrar que o debate de mercado tende a convergir para algumas ideias consistentes: automação exige governança, automação deve ser orientada a casos de uso bem definidos, e automação sem observabilidade tende a falhar na escala. Esses princípios são observados em diferentes contextos e servem como “base comum” para construir cenários robustos.
12) Conclusão: Scenario Automação como capacidade, não como projeto
Um cenário de automação bem planejado é uma capacidade organizacional: reduz incerteza, padroniza decisões e cria rastreabilidade. A diferença entre um resultado mediano e uma operação consistente está na disciplina do desenho do cenário — especialmente em regras, exceções, observabilidade e governança.
Quando a abordagem é realmente Scenario Automação, você ganha um mecanismo que melhora com o tempo: aprende com falhas, ajusta regras e sustenta valor com segurança. Se você me disser o tipo de processo que pretende automatizar (ex.: atendimento, faturamento, conformidade, onboarding, logística) e quais sistemas estão envolvidos, posso propor um modelo de cenário (entradas/saídas, regras e exceções) adequado ao seu contexto.
Ao tratar automação como capacidade, a organização consegue evoluir de forma previsível: novos cenários podem ser criados a partir de padrões existentes; catálogos de exceções podem ser reutilizados; métricas podem ser padronizadas; e governança pode ser aplicada com consistência. Isso transforma automação de “um conjunto de fluxos isolados” em uma arquitetura operacional que sustenta crescimento com controle.
Em suma, o caminho para resultados consistentes é construir cenários que sejam: (i) bem delimitados; (ii) baseados em regras explícitas; (iii) integrados com dados corretamente normalizados e semântica consistente; (iv) equipados com tratamento de exceções que reduz caos operacional; (v) monitorados por observabilidade com métricas e logs úteis; (vi) governados com versionamento e ritos de mudança. Quando esses elementos se juntam, a automação deixa de ser um experimento e vira uma alavanca sustentável de performance.
-

A Guide to Cost-Efficient Small Electric Cars for Seniors
-
Mastering Debt Consolidation: Boost Your Credit Score and Manage Interest Rates
-
Your Guide to Loans, Credit Checks, and Interest Rates
-
Affordable Independent Living: Finding the Right Senior Housing
-
Guide to Senior Living Apartments: Affordable and Comfortable Environments